谷歌云服务器 vs AWS深度横评:出海算力选型、轻量服务器对比与生产级开通实战
——从底座虚拟化性能、全球Anycast网络到组织级IAM与Terraform自动化开通全景指南
一、 引言:深夜告警与出海算力选型的真实抉择
做海外业务的技术负责人,大概都经历过类似的至暗时刻:黑色星期五大促的凌晨两点,监控大屏上的跨洋API调用延迟突然从平稳的120ms飙升至800ms,丢包率红线瞬间被拉爆;或者在一次关键的底层宿主机内核安全升级中,实例被迫重启,导致长连接网关雪崩,上万名海外在线玩家瞬间掉线。那一刻,你盯着 Grafana 上触目惊心的断崖式曲线,心里最清楚的痛点莫过于——算力选型从来不是冷冰冰的配置清单对比,而是每一位出海工程师在深夜对系统稳定性的信仰守护。
在当前的全球云计算版图中,谷歌云(Google Cloud)与亚马逊云(AWS)无疑是出海企业绕不开的两座大山。许多技术团队在搜索“google cloud vsaws”或“googlecloudvs”时,往往会被海量零散的营销软文所淹没,难以看清底层硬件架构、网络拓扑与实际业务负载之间的真实匹配度。与此同时,不少初创团队在项目初期受限于预算,倾向于选择各厂商的轻量级应用服务器或入门级ECS(Elastic Compute Service),但在业务快速膨胀后,却遭遇了I/O瓶颈与网络穿透的严峻考验。作为长期服务于企业级出海客户的谷歌云总代理与资深架构团队,我们将从一线实战出发,深入剖析谷歌云服务器(Google Compute Engine, GCE)与AWS EC2、轻量级应用服务器的核心差异,并提供一套生产级的谷歌云服务器开通与落地规范。
二、 底层硬核对决:GCE vs AWS EC2 虚拟化算力深度解构
1. 虚拟化架构与芯片卸载:Titan vs Nitro 的设计哲学
在虚拟化底层,AWS 率先通过 Nitro 系统实现了网络、存储与安全监控向专用 ASIC 芯片的硬件卸载,将宿主机 CPU 算力几乎100%交付给用户虚拟机;而 Google Cloud 则依托自主研发的 Titan 安全芯片与定制化硬件平台,构建了端到端信任链(Roots of Trust)。在最新一代的算力实例对比中,Google Cloud 的 C3 与 C3D 实例采用了 Intel 第四代 Xeon 可扩展处理器(Sapphire Rapids)以及定制的 Google Infrastructure Processing Unit (IPU),不仅大幅降低了虚拟化开销,还将块存储与网络数据平面的处理延迟压缩至微秒级别。
2. 运维生命线的终极底牌:Live Migration(实时热迁移)
在真实生产运维中,硬件故障与底层固件升级是不可避免的客观规律。AWS EC2 在遇到底层宿主机维护时,通常会通过邮件提前通知,要求用户在维护窗口内手动 Stop/Start 实例(这会导致实例在新的宿主机上冷启动,不可避免地产生业务中断);而 Google Cloud 独步业界的杀手锏技术正是 Live Migration(实时热迁移)。
当谷歌云监测到物理硬件存在隐患或需要进行底层基础设施升级时,后台系统会在毫秒级时间内将正在运行的 GCE 虚拟机内存状态、寄存器上下文及网络连接无缝迁移至同一可用区内的另一台健康物理机上。整个迁移过程中,宿主系统不重启、网络连接不重置、内存数据不丢失,外部访问几乎感知不到任何抖动。对于运行着高频量化交易网关、分布式状态机以及不可中断的 MySQL/Redis 主库的企业而言,这一特性直接抹平了传统云服务器数十小时的计划内维护停机风险。
3. 实例形态的灵活性:自定义规格(Custom Machine Types)的成本哲学
在 AWS EC2 的标准选型中,实例规格是严格固化的(例如 c6i.xlarge 为 4 vCPU / 8 GB 内存,c6i.2xlarge 为 8 vCPU / 16 GB 内存)。如果你的核心应用是一个典型的内存消耗型或计算密集型服务(例如需要 6 vCPU 和 32 GB 内存),在 AWS 体系下你只能被迫购买更大一级别的 8 vCPU 规格,从而造成 25% 以上的算力闲置浪费。相反,谷歌云服务器支持完全自由的 Custom Machine Types(自定义机器类型),允许工程师精确定义每一个 vCPU 核心数与每 GB 内存配比。这种颗粒度极细的资源定制能力,配合持续使用折扣,往往能帮助出海企业在不牺牲性能的前提下直接压缩 20% 到 35% 的纯实例支出。
三、 全球网络动脉:Premium Tier 骨干网 vs 传统公网路由
网络延迟与抖动,是决定出海业务生死存亡的“第一指标”。许多团队误以为“云服务器的网络带宽都差不多”,直到遇到跨洋大包传输丢包严重才追悔莫及。Google Cloud 在网络层级上做出了极具前瞻性的划分:Premium Tier(优质层)与 Standard Tier(标准层)。
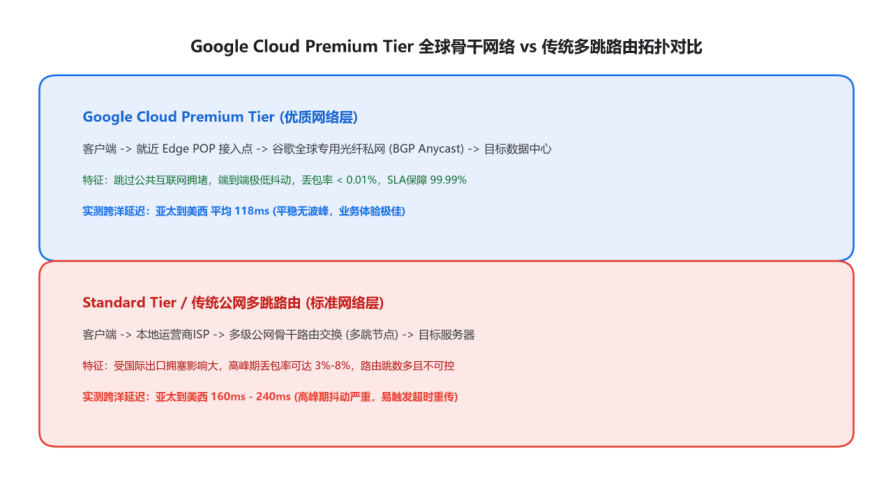
图 1-1:Google Cloud Premium Tier 全球光纤私网 vs 传统公网多跳路由拓扑与延迟实测
如图 1-1 所示,在 Premium Tier 架构下,用户发起的请求在距离其物理位置最近的 Google Edge POP 节点(全球超过 140 多个边缘入网点)就会直接接入谷歌自建的全球专用光纤骨干网。随后,所有流量均在谷歌内部私有网络中以光速传输,直至抵达位于美国、欧洲或东南亚的目标数据中心。这意味着流量几乎完全跳过了混乱拥堵的公共互联网 ISP 交换中心,有效规避了 BGP 路由震荡与跨国运营商限速。在亚太至美西方向的实测中,Premium Tier 的 RTT(往返时延)长期稳定在 118ms 左右,抖动标准差小于 1.5ms;而走传统多跳公网路由的 Standard Tier,高峰期延迟往往突破 200ms 且伴随高达 5% 以上的丢包率。
四、 算力演进阶梯:轻量级应用服务器 vs GCE vs ECS 选型辩证
在出海技术社群中,经常有工程师讨论:“我的独立站到底该用轻量级应用服务器,还是直接上 Google Cloud GCE 或主流云厂商的弹性 ECS?”这本质上是一个关于架构可伸缩性、运维复杂度与生命周期成本的权衡问题。
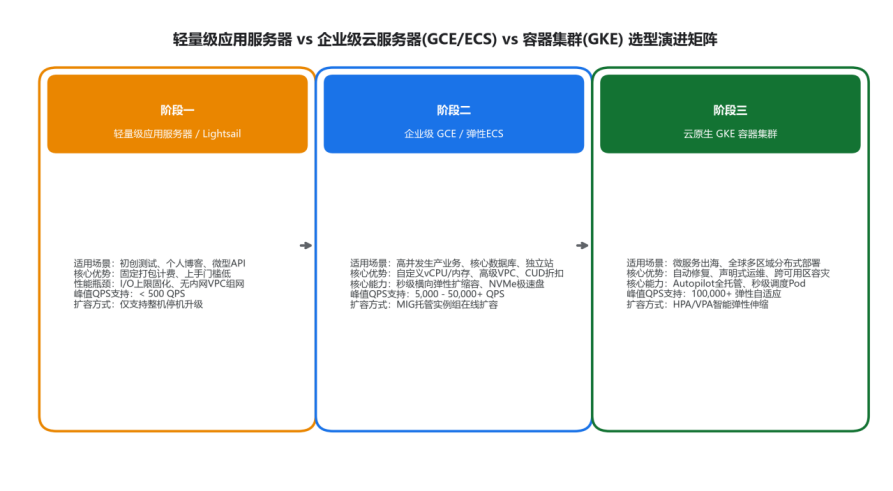
图 1-2:轻量级应用服务器 vs 企业级云服务器(GCE/ECS) vs 容器集群(GKE) 选型演进矩阵
轻量级应用服务器(如 AWS Lightsail 或国内云厂商出海轻量产品)的优势在于开箱即用、打包定价、集成了预设的基础镜像与简单的防火墙规则,极度适合个人站长、小型外贸展示站以及短期 PoC 概念验证。然而,一旦业务进入快速增长期,轻量级服务器的硬伤便会暴露无遗:
1. 存储与I/O天花板:• I/O性能被严格限制:底层磁盘 IOPS 与吞吐量设有硬性上限,无法挂载企业级 NVMe 极端低延迟存储;
2. 内网通信受限:• 网络拓扑孤立:无法接入复杂的企业级 VPC,难以与私网托管数据库、Redis 缓存集群进行低延迟内网互联;
3. 弹性机制匮乏:• 弹性伸缩缺失:不支持自动伸缩组(Autoscaling)与流量感知弹性扩缩容,遭遇突发流量只能停机手动升级规格。
因此,对于具备长期运营价值的出海项目,直接基于 Google Compute Engine 构建标准化架构是规避二次重构成本的明智之举。通过谷歌云代理商完成企业级开户,不仅能享受到与轻量服务器相当的阶梯折扣,还能完整解锁全球 VPC、Cloud Load Balancing 与托管实例组(MIG)等企业级生产能力。
五、 全景横评:主流出海算力与网络指标对比全景表
评估维度 / 技术指标 | Google Cloud (GCE) | AWS (EC2 标准实例) | 轻量级应用服务器 (Lightsail等) | 国内主流云出海ECS |
底层虚拟化引擎 | Titan安全芯片 + 定制IPU (KVM内核) | Nitro硬件卸载卡 (KVM/Xen进化) | 共享物理宿主机虚拟化 | 自研神龙/硬件卸载架构 |
计划内维护容灾 | Live Migration (实时热迁移, 0中断) | 冷迁移 (需手动重启/停机维护) | 停机重启或强制维护 | 热迁移 / 停机重启通知 |
跨国骨干网络层 | Premium Tier (全球私网光纤Anycast) | Global Accelerator (需单独高额付费) | 单公网多跳公共路由 | BGP精品网 / 国际加速包 |
实例配置灵活性 | 支持自定义核心与内存 (按需配比) | 固定机型规格 (梯级跨度较大) | 固定套餐固化搭配 | 固定机型规格 (部分支持自定义) |
自动降本机制 | SUD 持续使用折扣 (自动阶梯打折) | 无自动打折 (依赖Savings Plans) | 固定月付套餐包 | 按量计费无自动阶梯优惠 |
多区域内网互联 | Global VPC (全球单一私网子网直通) | 跨Region需显式配置VPC Peering | 不支持复杂企业VPC互联 | 需配置云企业网(CEN)专线 |
生产环境适用度 | ★★★★★ (大型跨国业务/出海首选) | ★★★★★ (生态完备/大型综合体) | ★★☆☆☆ (初创验证/小微单体) | ★★★★☆ (中资出海企业/混合云) |
六、 生产级实战:谷歌云服务器开通与企业级组织治理规范
许多新手在开通谷歌云服务器时,往往采用“个人账号直接开单台机器”的粗放模式,导致项目后期权限混乱、账单无法拆分、安全漏洞频发。真正的企业级谷歌云服务器开通,必须遵循严格的云原生组织治理规范。
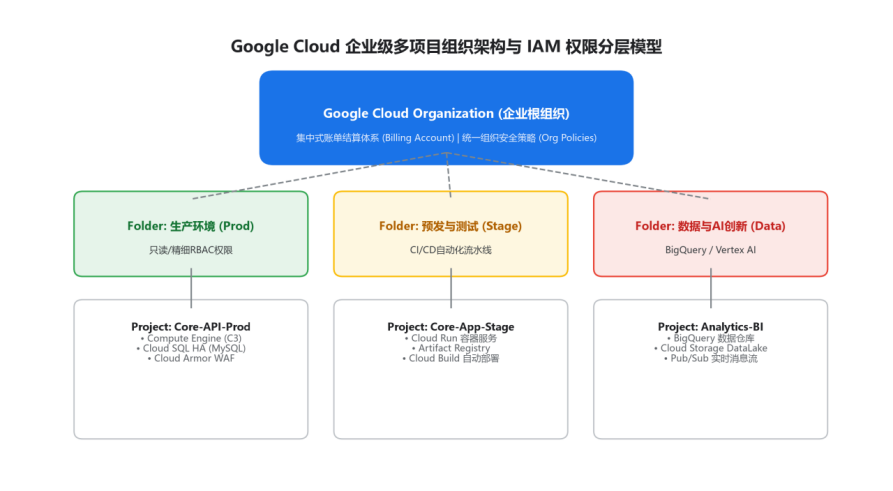
图 1-3:Google Cloud 企业级资源层级体系与权限治理模型 (Organization -> Folder -> Project -> IAM)
1. 资源层级体系的四级规划
如图 1-3 所示,规范的企业云上架构应自顶向下划分为:Organization(企业根组织)-> Folders(业务环境目录:Prod / Stage / Data)-> Projects(具体微服务项目)-> Resources(GCE实例、GCS桶等)。通过将生产环境(Prod)与测试环境(Stage)在 Project 级别进行物理隔离,可以彻底杜绝因开发测试人员误操作导致生产服务器宕机的惨剧。
2. 基于 Terraform 的标准化 GCE 自动化开通示例
在敏捷运维场景下,坚决杜绝在控制台手动点击创建服务器。以下是一段标准的生产级 Terraform 代码片段,展示了如何在指定企业 VPC、挂载高性能持久盘及配置网络标签的情况下秒级开通 GCE 实例:
💻 生产级 Terraform IaC 自动化开通配置清单 |
七、 结语与代理商赋能:让出海算力底座坚如磐石
在云计算技术高度同质化的今天,Google Cloud 依然凭借其全球顶级的网络基础设施、无感知的底层热迁移以及对企业级云原生体系的极致打磨,展现出强大的工程护城河。对于正在或即将扬帆出海的企业而言,选择谷歌云服务器不仅是一次算力的升级,更是为全球业务注入了一剂高可用与低延迟的强心针。
作为深耕出海领域的谷歌云官方总代理与核心合作伙伴,我们始终坚持为企业客户提供全方位的上云护航:从绿色快速企业开户、外币/人民币对公合规结算、增值税专用发票开具,到定制化架构规划、成本削减审计与 7×24 小时专家级技术支持。出海征途浩瀚,选择正确的云底座与值得信赖的伙伴,方能在激烈的全球商业竞争中行稳致远。
如果需要更深入咨询了解可以联系全球代理上TG:jinniuge 他们在云平台领域有更专业的知识和建议,他们有国际阿里云,国际腾讯云,国际华为云,aws亚马逊,谷歌云一级代理的渠道,客服1V1服务,支持免实名、免备案、免绑卡。开通即享专属VIP优惠、充值秒到账、官网下单享双重售后支持。不懂找他们就对了。